VideoRoll 字幕服务性能优化实录:从 CPU 烧字到 GPU 合成,再到字幕事件级缓存
Abstract
这篇笔记记录 VideoRoll 字幕服务一次比较完整的性能优化过程。
一开始我们只知道:显卡明明在做硬件编码,但字幕压制还是慢,GPU 利用率也不高。
后面一步步拆解才发现:
av1_vaapi只代表编码器在 GPU 上,并不意味着整条 FFmpeg filter graph 都在 GPU。真正拖慢流水线的,是夹在硬件解码和硬件编码中间的libass软件字幕滤镜,以及 CPU/GPU 之间反复搬运的大尺寸帧。最终这条链路经历了几次明显变化:
- 全帧
hwdownload -> libass -> hwupload- 主视频留在 GPU,只让 CPU 生成透明字幕平面
- 只生成底部字幕 band
- 静态 ASS 把字幕平面刷新率降到 15 FPS
- 再进一步:只在字幕状态变化时调用 libass
- 状态图片通过
image2pipe送给 FFmpeg,再由overlay_vaapi在 GPU 合成- 最后把 OpenVINO ASR 的 GPU 资源调度、在线 Whisper 也整理成独立资源模型
这篇文章重点不是“某个 FFmpeg 参数”,而是如何通过现场监控、filter graph、代码审查和生产 A/B,一步步确认真正的瓶颈。
1. 最开始的问题:为什么用了 GPU 还是慢?
VideoRoll 的生产渲染节点使用 Intel Arc A380。
我们原本希望链路类似:
Decode -> Subtitle -> Encode
   GPU        GPU        GPU
但生产现场并不是这样。
同时跑多个渲染任务时,可以确认:
- FFmpeg 确实使用 VAAPI;
- AV1 编码器确实是
av1_vaapi; - 两张 A380 都有 Video engine 负载;
- 但 GPU 并没有持续跑满;
- 单个 FFmpeg 进程会吃掉一部分 CPU;
- 更奇怪的是:整台机器还有大量空闲 CPU。
一次线程级采样中,系统整体 CPU 仍然大约有 74% idle。
这说明它并不是简单的:
“CPU 总算力不够。”
而更像:
流水线中存在低并行度的 CPU 阶段,GPU 在等 CPU 把下一帧准备好。
这也是整个优化真正开始的地方。
2. 第一条关键经验:硬件编码 ≠ 全 GPU 流水线
FFmpeg 命令里看到:
-c:v av1_vaapi非常容易产生一个错觉:
视频已经完全走 GPU。
实际上 FFmpeg 是一个 filter graph。
只要中间某个滤镜只能处理 software frame,就可能出现:
GPU frame
   ↓
hwdownload
   ↓
System RAM
   ↓
Software filter
   ↓
hwupload
   ↓
GPU frame
ASS 字幕就是典型例子。
早期 VideoRoll 的 legacy 路径本质上接近:
VAAPI Decode
    ↓
scale_vaapi
    ↓
hwdownload
    ↓
CPU software frame
    ↓
libass / ass
    ↓
CPU software frame
    ↓
hwupload
    ↓
VAAPI Encode
对应的 filter 结构接近:
scale_vaapi=format=...
hwdownload
format=...
ass=subtitle.ass
format=...
hwupload
对于 4K 视频,这非常贵。
一帧 3840×2160 的画面本身就很大;如果每一帧都要:
- 从 GPU 拉回 system memory;
- 在 CPU 做 libass 合成;
- 再上传回 GPU;
那么编码器再快,也会被 filter 前级喂不饱。
3. 我们是怎么判断“不是编码器不够快”的?
3.1 先看 FFmpeg 实际速度
生产 Worker 日志里,不同素材的速度差别很大。
曾经同时看到类似:
fps=14   speed=0.234x
fps=19   speed=0.313x
fps=17   speed=0.280x
fps=56   speed=2.240x
fps=16   speed=0.262x
同一套硬件、同一种 VAAPI 编码环境,却可以从 0.2x 到 2x 以上。
如果瓶颈只是 AV1 encoder 完全饱和,这种差距不会这么大。
3.2 再看 Intel GPU 物理引擎
常用:
intel_gpu_top -d drm:/dev/dri/renderD128另一张卡:
intel_gpu_top -d drm:/dev/dri/renderD129当时可以确认:
Video engine:有负载
Compute:有负载
但都没有长期 100%
短样本中常见大致:
Video   20% ~ 40%
Compute  5% ~ 10%
关键不是数字精确到个位数,而是:
GPU 确实在工作,但它明显在等。
3.3 看 FFmpeg 的线程,而不是只看整机 CPU
top -H -p <ffmpeg-pid>结果是:
- 少数线程比较忙;
- 很多 FFmpeg thread sleeping;
- 整台机器仍然有大量 idle CPU。
这很符合一个 feeder bottleneck:
CPU software filter
      ↓
准备出下一帧
      ↓
GPU 才能继续
所以后来我们不再问:
“GPU 为什么没满?”
而改成问:
“GPU 前面到底是谁在喂数据?”
4. 第一次真正有效的改动:主视频不要再回 CPU
关键提交:
9223428 perf: compose subtitle band on Intel GPU优化方向变成:
flowchart LR
    A[VAAPI decoded main video] --> B[GPU main frame]
    S[CPU libass subtitle plane] --> U[BGRA hwupload]
    B --> O[overlay_vaapi]
    U --> O
    O --> E[VAAPI encode]
新的核心思想是:
主视频永远留在 GPU。
CPU 不再负责“把字幕直接烧到 4K 主画面”。
CPU 只负责生成一个透明字幕平面。
大致变成:
Main video:
[0:v]scale_vaapi=format=...[main]

Subtitle:
transparent color
    ↓
ass=...:alpha=1
    ↓
format=bgra
    ↓
hwupload
    ↓
[sub]

Compose:
[main][sub]overlay_vaapi
项目最终的 live GPU overlay 路径核心就是:
[0:v]scale_vaapi=format=...[main];
[1:v]ass=subtitle.ass:alpha=1,format=bgra,hwupload[sub];
[main][sub]overlay_vaapi=x=0:y=...:shortest=1[out]
这一步把最重的事情去掉了:
4K main frame
GPU -> CPU -> GPU
5. 但问题没有完全消失:透明字幕层本身也很重
主视频留 GPU 后,速度明显改善。
但继续调查时发现:
libass 虽然只画透明字幕平面,但这个平面仍然可能非常大。
生产 ASS 实际出现过:
3840 × 916
3840 × 1008
3840 × 1204
以:
3840 × 1204 × 4 bytes计算,一张未压缩 BGRA 大约就是 18 MB 级别。
如果每秒生成几十张,再:
CPU raster
→ BGRA
→ hwupload
仍然会有明显成本。
6. 为什么字幕 band 会大到 1204 px?
代码会分析 ASS:
- FontSize
- Outline
- MarginV
- Alignment
\N换行- style reset
估算一条 Dialogue 需要的高度:
line_height_sum += font_size * 1.22 + outline * 2.0
required_height = max(
    required_height,
    line_height_sum + margin_v + 32.0,
)
问题在于:
这是扫描整部视频后的最大值。
所以如果 30 分钟视频里只有一条字幕是 6 行:
绝大多数:1~2 行
某一条:  6 行
整部视频都可能一直使用“能装 6 行字幕”的透明平面。
这等于拿全片最坏情况作为每一帧成本。
7. 缩小 subtitle band
后续提交:
d50b781 perf(render): reduce static subtitle overlay work最终代码不再固定给 4K 视频保留很大的百分比,而是以真实字幕 geometry 为主。
现在类似:
min_band = max(
    96,
    min(192, round(video_height * 0.12)),
)

band_height = max(min_band, required_height)
同时保留 conservative fallback。
如果 ASS 中出现:
\pos
\move
\org
\clip
\iclip
特殊 alignment
drawing
就不强制走底部 band,因为这些字幕可能故意出现在画面其它位置。
这条经验很重要:
高性能路径应该是“确认安全才进入”,而不是默认假设所有字幕都简单。
8. 下一步:静态字幕根本不需要 60 FPS 重画
做完 subtitle band 后,又出现一个更明显的问题:
假设字幕:
00:10.000 -> 00:13.000
Hello World
这 3 秒内字幕完全不变。
60 FPS 视频意味着:
3 × 60 = 180 frames但这 180 帧的字幕像素其实完全一样。
所以我们先做了一个保守优化:
Main video:     60 FPS
Subtitle plane: 15 FPS
overlay_vaapi 的 framesync 会在字幕帧之间重复最近一帧。
对普通静态字幕,视觉上不会变化。
这已经让 libass raster 次数下降很多。
9. 什么字幕不能降刷新率?
ASS 不等于“静态文本”。
以下效果都可能在 Dialogue 的 start/end 中间继续变化:
\t(...)
\move(...)
\fad(...)
\fade(...)
\k
\kf
\ko
\kt
还有 Effect:
Banner
Scroll up
Scroll down
所以项目里的 _ass_can_use_reduced_overlay_rate() 会先检查:
普通静态 Dialogue
    → 可以 reduced overlay rate

动画 / karaoke / move / fade
    → 保持 live path
Warning
不能简单做“每个 Dialogue start/end 更新一次”然后宣称支持全部 ASS。
对 karaoke、fade、move 来说,这会直接丢动画。
10. 真正的突破:从“逐帧渲染”改成“字幕事件级缓存”
15 FPS 已经比 60 FPS 好。
但我们后来继续问了一句:
15 FPS 本质上还是在重复做相同工作。
假设 30 秒视频:
30 × 15 = 450 张 subtitle plane但这一段字幕真正不同的视觉状态,可能只有:
9 个那为什么要调用 libass 450 次?
于是有了:
af129c3 perf(render): cache static subtitle events核心思想变成:
libass 不再按视频帧工作,而只在字幕状态变化时工作。
11. 什么叫“字幕状态变化”?
对于普通 ASS:
Dialogue A: 1s -> 3s
Dialogue B: 4s -> 6s
真正可能改变视觉内容的时间点只有:
0s
1s   A 出现
3s   A 消失
4s   B 出现
6s   B 消失
项目里会解析每条 Dialogue::
start
end
然后收集:
boundaries = {
    0.0,
    start_1,
    end_1,
    start_2,
    end_2,
    ...
}
排序后得到:
event boundaries每两个 boundary 之间,字幕画面是稳定的。
12. Event Cache 的完整流程
flowchart TD
    A[ASS file] --> B{是否静态 ASS?}
    B -- 否 --> L[Live libass overlay]
    B -- 是 --> C[解析 Dialogue start/end]
    C --> D[生成 event boundaries]
    D --> E{状态数量是否值得缓存?}
    E -- 否 --> L
    E -- 是 --> F[libass 只渲染状态变化点]
    F --> G[state_000001.png]
    F --> H[state_000002.png]
    F --> I[state_000003.png]
    G --> J[image2pipe]
    H --> J
    I --> J
    J --> K[BGRA hwupload]
    K --> M[overlay_vaapi]
    N[VAAPI main video] --> M
    M --> O[VAAPI encode]
13. Event Cache 是怎么生成状态图片的?
项目会先生成一张透明 blank:
color=c=black@0.0
format=rgba
然后根据 event boundary 构造一个 ffconcat 时间轴:
ffconcat version 1.0

file blank.png
duration 1.000000

file blank.png
duration 2.000000

file blank.png
duration 1.000000
...
这些 duration 对应:
boundary[n+1] - boundary[n]再让 FFmpeg:
-vf "ass=subtitle.ass:alpha=1,format=rgba" \
-fps_mode passthrough
只在这些时间点输出:
state_000001.png
state_000002.png
state_000003.png
...
这时候 libass 的计算规模就从:
O(video_frames)变成更接近:
O(subtitle_state_changes)对于长视频的普通字幕,这个差距非常大。
14. 缓存生成后,怎么重新变成“视频流”?
最终编码器仍然希望第二路输入是一个视频流。
所以 VideoRoll 做了一个 producer:
for frame_number in range(output_frame_count):
    timestamp = frame_number / overlay_fps

    state_index = latest_boundary_before(timestamp)

    if state_index != active_index:
        active_png = read_png_for_this_state()

    pipe.write(active_png)
FFmpeg 侧:
-f image2pipe \
-framerate 15 \
-vcodec png \
-i pipe:0
然后:
[1:v]format=bgra,hwupload[sub];
[main][sub]overlay_vaapi=
    x=0:
    y=...:
    shortest=1:
    repeatlast=1
[out]
最关键的一点:
producer 虽然仍然按 15 FPS 输出 overlay stream,但同一个字幕状态反复复用同一个 PNG,不再反复调用 libass 去重新画相同文本。
15. Event Cache 不是所有字幕都强制开启
缓存也有成本。
如果字幕变化特别频繁:
每几十毫秒一个状态那生成上千张 PNG 可能不划算。
所以项目里给 Event Cache 做了 admission gate。
当前逻辑里有这些限制:
必须通过 static ASS 检查

event boundaries >= 2

最大状态数:
<= 4096

至少有一定长度:
output frames >= 90

状态变化比例:
states / output_frames <= 20%

缓存总大小:
<= 256 MiB
如果不值得缓存:
ASS event cache skipped: ...就回退到:
live-static如果 overlay_vaapi 都不可用,再回到:
legacy-full-frame因此最终不是“一条脆弱的快路径”,而是多级 fallback:
flowchart TD
    A[Render] --> B{overlay_vaapi 可用?}
    B -- 否 --> Z[Legacy full-frame]
    B -- 是 --> C{ASS 可使用 subtitle band?}
    C -- 是 --> D[Subtitle band]
    C -- 否 --> E[Full transparent subtitle plane]
    D --> F{静态 ASS?}
    E --> F
    F -- 否 --> G[Live libass + overlay_vaapi]
    F -- 是 --> H{Event cache eligible?}
    H -- 否 --> I[15fps live libass]
    H -- 是 --> J[Event cache PNG states]
    J --> K[image2pipe]
    K --> L[hwupload]
    L --> M[overlay_vaapi]
    I --> M
    G --> M
16. 一个真实生产 Bug:ASS 时间轴可能比视频长
第一次 event cache 实现完成后,又碰到一个边界问题。
假设:
视频真实时长:30.0s
ASS 最后一条字幕:35.0s 才结束
如果直接把 ASS 最后一个 event boundary 当成 cache 时间轴终点:
cache producer可能继续输出超过媒体真实时长的帧。
最终修复:
6a913f7 fix(render): bound subtitle cache to video duration现在会先通过 ffprobe 得到真实:
video_duration然后只保留:
boundary <= duration_seconds并且:
timeline_end = actual_video_duration这条经验非常通用:
做 timeline cache 时,媒体文件是真正的时钟源;字幕文件的时间戳不能默认等于媒体时长。
17. 生产 4K60 A/B:最终到底快了多少?
最终不是只跑 unit test,而是直接拿生产视频做 A/B。
测试条件:
分辨率:3840 × 2160
帧率:  60 FPS
编码:  AV1 VAAPI
GPU:   Intel Arc A380
片段:  30 秒
质量:  CQP 26
VAAPI quality:5
字幕:  真实生产 ASS
比较:
旧快速路径:
15fps live-libass + overlay_vaapi

新路径:
event-cache + image2pipe + overlay_vaapi
结果:
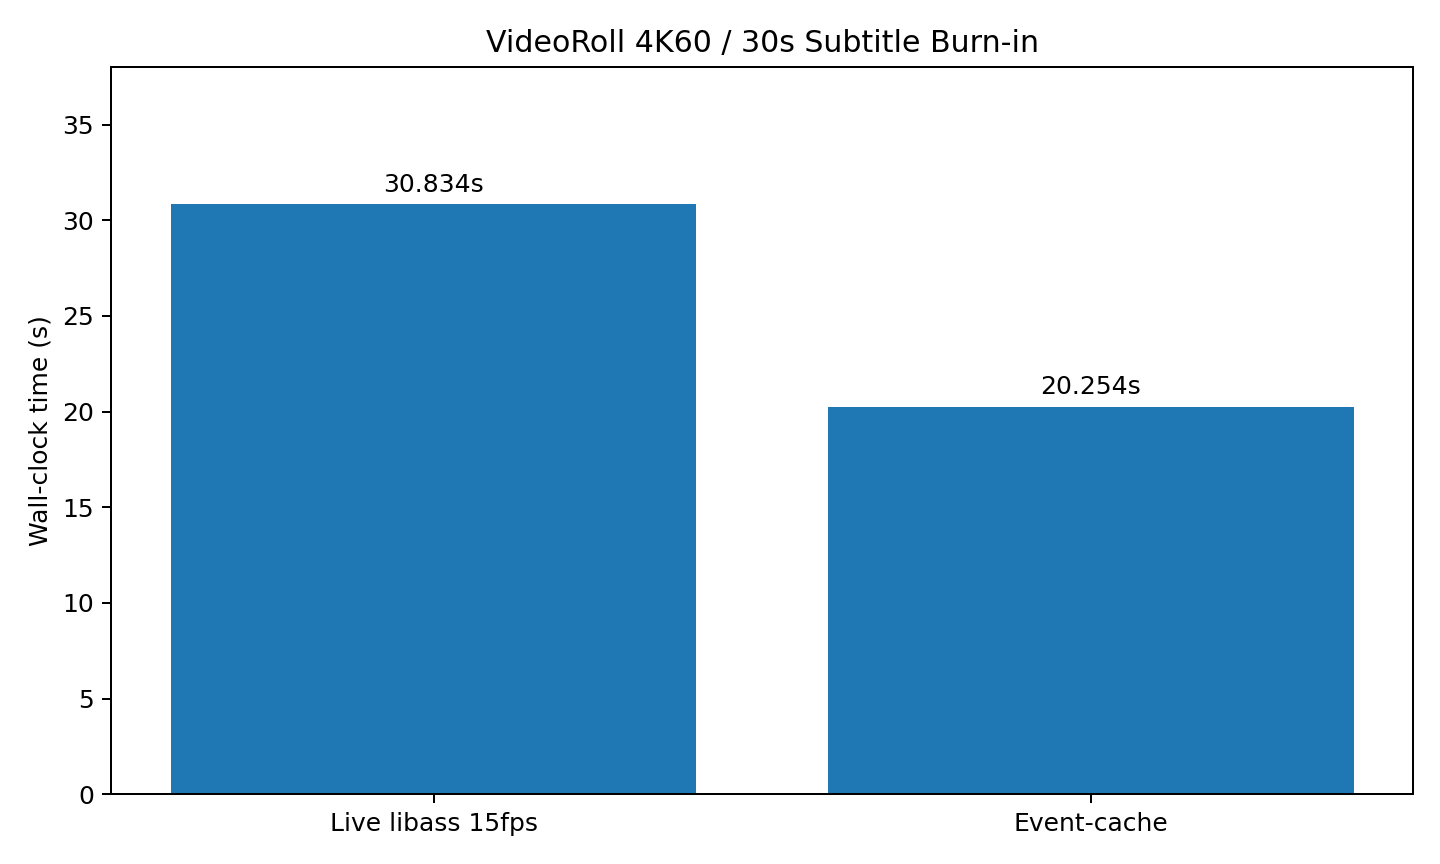
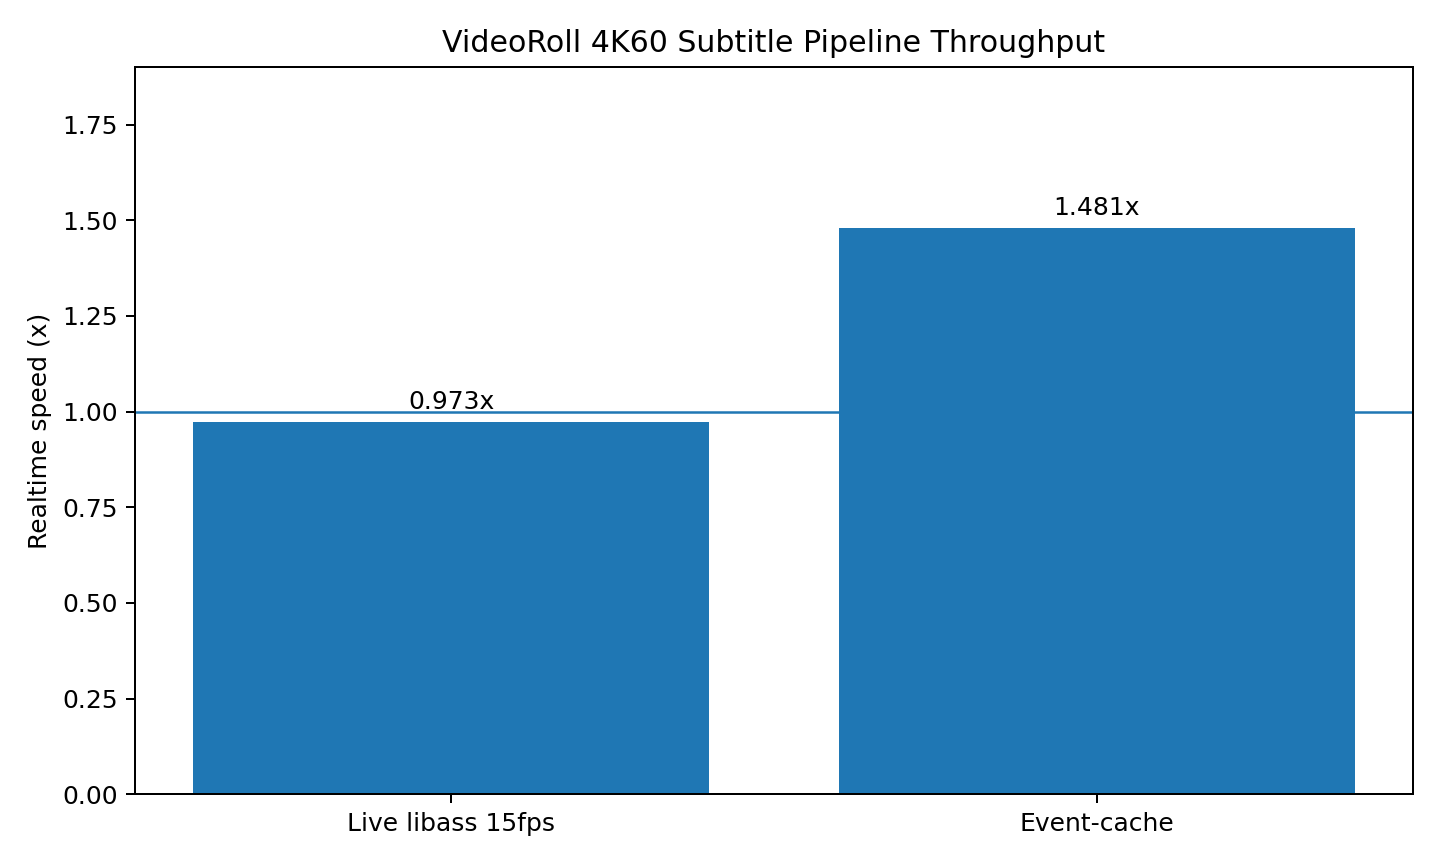
| 路径 | 30 秒样本总耗时 | 综合速度 |
|---|---|---|
| 15fps live-libass | 30.834 s | 0.973x |
| event-cache | 20.254 s | 1.481x |
换算:
总耗时下降约 34.3%
吞吐提升约 52.2%
新路径的 FFmpeg 主编码阶段还曾达到约:
1.68x realtime而且这里的:
20.254 s已经包含 event cache 的构建时间。
18. 这 30 秒样本里到底缓存了多少东西?
这次生产样本:
ASS 原始 events:210
实际 cache states:9
overlay 输出 frames:452
PNG 总大小:782,644 bytes
cache build:1.286 s
状态/输出 frame 比例:
9 / 452 ≈ 1.99%也就是说从计算逻辑看:
旧路径接近:
450 次:
    libass raster
    alpha composition
    pixel conversion
    BGRA preparation
    hwupload
新路径接近:
9 次:
    libass raster

然后:
    复用已有状态 PNG
    image2pipe
    hwupload
这就是 event-oriented rendering 真正带来的差异。
19. 怎么确认“快了,但字幕没有被改坏”?
字幕优化最大的风险不是 crash。
而是:
速度提高了,但字幕某些帧提前、延迟、透明度或边缘发生细微变化。
所以最后做了逐帧 alpha 验证。
同一段字幕:
live-libass alpha frames:450
event-cache alpha frames:450
逐帧 MD5:
450 / 450 完全一致
mismatch = 0
也就是说对这个静态 ASS 样本:
- 出现时间一致;
- 消失时间一致;
- 字形边缘一致;
- alpha 一致;
- 透明度一致。
这一步建议保留成长期 regression test。
20. 优化以后,GPU 为什么还是没有 100%?
event cache 上线后,对单张 A380 做过一段短采样:
Video engine
平均约 16.5%
峰值约 44.8%

Compute
平均约 3.7%
峰值约 10.3%

RC6
平均约 62.9%
这时候继续追求“GPU 必须 100%”反而容易走错方向。
之前:
GPU 低
因为 GPU 在等 CPU 每帧画字幕
现在:
GPU 低
因为单个任务本身不足以吃满整张卡
这两个含义完全不同。
正确 KPI 应该是:
wall-clock time
videos / hour
jobs / hour
failure rate
cost / video
不是单独看:
GPU %如果:
30.834s -> 20.254s即使 GPU 没有 100%,优化仍然是成功的。
21. 10-bit 视频不能被“顺手忽略”
中间还有一个重要提交:
ebd43d1 perf: extend GPU subtitle overlay to 10-bit video如果源视频是 10-bit:
P010 / 10-bit pixel format不能简单套一个固定的 8-bit format。
最终思路仍然是:
- probe source bit depth;
- 选择相应 VAAPI/software pixel format;
- 主画面继续保留 hardware frame;
- 只在必须时做 software conversion;
- 快路径失败必须 fallback。
这让优化从一个“只对某类 8-bit 视频快”的 hack,逐渐变成正常渲染框架的一部分。
22. 调查 FFmpeg 时,真正有用的几个命令
硬件加速能力
ffmpeg -hide_banner -hwaccelsVAAPI/QSV encoder
ffmpeg -hide_banner -encoders | grep -E 'vaapi|qsv'filter 支持
ffmpeg -hide_banner -filters | grep -E 'ass|overlay|overlay_vaapi'特别关注:
ass
overlay_vaapi
生产 FFmpeg 真正执行了什么
ps -ef | grep '[f]fmpeg'必要时:
tr '\0' ' ' < /proc/<PID>/cmdline不要只看“我们代码计划生成什么命令”。
一定要看:
生产进程真正拿到的 argv。
Intel GPU
intel_gpu_top指定设备:
intel_gpu_top -d drm:/dev/dri/renderD128另一张卡:
intel_gpu_top -d drm:/dev/dri/renderD129FFmpeg 线程
top -H -p <PID>如果看到:
系统整体 CPU 很空
FFmpeg 少数 thread 很忙
GPU 也不满
就非常值得检查:
software filters
framesync
hwdownload
pixel format conversion
ffprobe
ffprobe -v error \
  -select_streams v:0 \
  -show_entries stream=width,height,r_frame_rate,pix_fmt,duration \
  -show_entries format=duration \
  -of json \
  input.mp4
Event Cache 和 10-bit 路径都非常依赖:
width
height
frame rate
pixel format
duration
23. 一个我以后会优先检查的关键词:hwdownload
如果已经启用 GPU,但实际速度不像 GPU:
第一时间搜索:
hwdownload再看:
hwupload如果链路是:
GPU
↓
hwdownload
↓
大尺寸 software filter
↓
hwupload
↓
GPU
那通常就是最值得调查的位置。
不是说 hwdownload 一定错误。
很多软件滤镜确实无法直接处理 hardware frame。
真正的问题是:
是否有必要把整个主画面下载下来?
字幕场景的答案最终是:
没有必要。CPU 只需要生成字幕 plane。
24. 字幕 ASR 又暴露出另一个“看起来配置了 GPU,实际没进去”的问题
字幕渲染优化之后,ASR 又遇到过 OpenVINO 错误:
[GPU] Context was not initialized for 0 device第一反应很容易怀疑:
- Intel driver;
- OpenVINO plugin;
- GPU context;
- 多进程争用;
- 模型本身。
但现场检查真正执行 ASR 的容器后发现:
subtitle-service:能看到 GPU
subtitle-worker:只能看到 CPU
而配置却仍然是:
SUBTITLE_OPENVINO_DEVICE=GPU也就是说:
代码要求 GPU
容器没有 /dev/dri
OpenVINO 当然无法初始化 GPU context。
对应修复:
dfdd083 fix(subtitle): expose Intel GPU to worker给真正执行 ASR 的 worker 暴露:
devices:
  - /dev/dri:/dev/dri
并加入对应 render group。
修完之后:
from openvino import Core
print(Core().available_devices)
能够看到:
['CPU', 'GPU']25. 中间一个我们主动纠正的错误设计:把整个 worker 并发压成 1
当时还发现另一个风险:
Whisper large-v3 FP16
+
Celery prefork concurrency = 4
+
同一张 A380
四个独立进程如果同时加载 OpenVINO 模型,容易造成显存和 context 压力。
为了止血,一度做过:
subtitle-worker concurrency cap = 1它确实能避免多个 OpenVINO 任务同时抢 GPU。
但这个方案很快就被否掉了。
因为 VideoRoll 的语义应该是:
任务队列 max_concurrency
    ↓
控制除渲染外的普通任务并行数
这些普通任务包括:
下载
ASR
翻译
RAG
字幕生成
其它处理
如果把整个 subtitle worker 固定成 1,就意味着:
一个 ASR 在跑
↓
下载不能跑
翻译不能跑
RAG 不能跑
这显然不符合原本的任务调度设计。
26. 正确做法:锁“GPU 资源”,不是锁“整个 worker”
最终提交:
790d746 fix(subtitle): isolate OpenVINO GPU concurrency恢复:
Celery --concurrency
=
任务队列管理设置
例如管理页设置:
max_concurrency = 4生产 worker 就仍然是:
--concurrency 4但只有真正进入:
OpenVINO GPU model load/generate时才争抢一个 GPU resource slot。
实现使用:
PostgreSQL transaction-scoped advisory lock大致结构:
flowchart LR
    W1[Worker 1] --> D[Download]
    W2[Worker 2] --> T[Translate]
    W3[Worker 3] --> G[OpenVINO GPU Slot]
    W4[Worker 4] --> R[RAG]

    G --> O[Whisper OpenVINO GPU]
这样可以同时满足:
普通任务池仍然 4 并发
OpenVINO GPU 临界区安全串行
而不是:
整个字幕服务被迫 1 并发27. 为什么选 PostgreSQL advisory lock?
这里没有简单用:
threading.Lock()因为 Celery 是 prefork:
多个独立进程普通 Python Lock 不能跨进程协调。
也没有把正确性完全依赖一个 best-effort Redis 限流器,而是用了数据库 transaction-scoped advisory lock。
它的几个优点:
跨进程
跨 Celery prefork
多容器可协调
connection/transaction 结束自动释放
进程异常退出后不容易留下永久锁
实际还做过两个进程同时争抢的测试:
GPU critical section overlap = 0.0s同时整个 Celery pool 仍然保持 4 worker。
这件事后来形成了一个很重要的架构原则:
“任务并发”和“资源并发”不是同一个东西。
28. 渲染并发也必须单独管理
VideoRoll 后面把并发语义拆得更明确:
普通任务队列并发
!=
OpenVINO GPU resource slots
!=
Render Worker concurrency
当前思路:
flowchart TD
    Q[任务队列管理] -->|max_concurrency| C[Celery 普通任务池]
    C --> D[下载]
    C --> A[ASR]
    C --> T[翻译]
    C --> R[RAG / Agent]

    A --> OG[OpenVINO GPU Slot]

    RM[渲染管理] -->|worker max_concurrency| RW[Render Worker]
    RW --> G0[GPU 0]
    RW --> G1[GPU 1]
例如:
普通任务队列 = 4
Render Worker = 6
可以同时存在:
4 个普通处理任务
+
6 个渲染任务
这两套并发不应该互相覆盖。
29. 再往后:直接接在线 Whisper / 自建 Faster-Whisper
有了本地 OpenVINO 以后,我们又把已有的 external-whisper 路径整理成了更明确的:
在线 Whisper
(自建 faster-whisper / OpenAI-compatible)
对应提交:
8b9f06c feat(asr): add configurable online whisper这样 ASR 不必一定运行在 VideoRoll 生产节点。
可以变成:
VideoRoll subtitle-worker
        ↓
HTTP
        ↓
独立 Faster-Whisper GPU Server
这实际上把:
ASR GPU从本机资源,变成了一个远程服务。
30. 在线 Whisper 调的是什么 API?
采用 OpenAI-compatible:
POST /v1/audio/transcriptions使用:
multipart/form-data字段:
file
model
response_format=verbose_json
language(可选)
如果服务需要鉴权:
Authorization: Bearer <token>如果是局域网里自建 Faster-Whisper:
API Key 可以留空这次专门把之前“必须有 API Key”的限制去掉了。
31. curl 直接测试 Faster-Whisper
最基础:
curl \
  -X POST \
  'http://WHISPER_HOST:8000/v1/audio/transcriptions' \
  -F 'file=@audio.wav' \
  -F 'model=whisper-1' \
  -F 'response_format=verbose_json'
指定语言:
curl \
  -X POST \
  'http://WHISPER_HOST:8000/v1/audio/transcriptions' \
  -F 'file=@audio.wav' \
  -F 'model=whisper-1' \
  -F 'response_format=verbose_json' \
  -F 'language=zh'
有鉴权:
curl \
  -H 'Authorization: Bearer YOUR_TOKEN' \
  -X POST \
  'https://whisper.example/v1/audio/transcriptions' \
  -F 'file=@audio.wav' \
  -F 'model=whisper-large-v3' \
  -F 'response_format=verbose_json'
VideoRoll 当前允许用户在 ASR 设置里填写:
http://WHISPER_HOST:8000或者:
http://WHISPER_HOST:8000/v1甚至直接填写:
http://WHISPER_HOST:8000/v1/audio/transcriptions后端会规范化成正确 endpoint。
32. 一个很容易踩的网络坑:127.0.0.1 到底是谁?
在线 Whisper 请求不是浏览器发的。
真正发请求的是:
subtitle-worker所以如果 Faster-Whisper 在另一台机器:
WHISPER_HOST = 那台机器的局域网 IP/域名不能因为自己桌面浏览器访问:
http://127.0.0.1:8000没问题,就把这个地址填进 VideoRoll。
对于 Docker 容器:
127.0.0.1
=
容器自己
除非 Whisper 就跟它在同一个 network namespace,否则一定连不到。
Note
在线 ASR 配置里的“地址可达性”,应该站在 生产 subtitle-worker 的视角判断,而不是站在浏览器的视角。
33. API 返回怎么统一成内部字幕时间轴?
标准 verbose_json 一般类似:
{
  "text": "hello world",
  "segments": [
    {
      "start": 0.25,
      "end": 1.50,
      "text": "hello world"
    }
  ]
}
VideoRoll 优先读取:
segments[]转换成统一内部结构:
Segment(
    start=...,
    end=...,
    text=...
)
如果某些兼容实现只返回:
{
  "text": "hello world"
}
则 fallback 成:
start = 0
end   = audio duration
的一条 segment。
这样可以兼容更多轻量 Faster-Whisper server。
34. 整条字幕系统最后是什么结构?
flowchart TD
    V[Video / Audio] --> ASR{ASR Engine}

    ASR --> FW[Local faster-whisper]
    ASR --> OV[OpenVINO GPU]
    ASR --> OW[Online Whisper API]
    ASR --> GQ[Groq Whisper]
    ASR --> CF[Cloudflare Workers AI]

    OV --> SLOT[OpenVINO GPU Resource Slot]

    FW --> S[Segments]
    SLOT --> S
    OW --> S
    GQ --> S
    CF --> S

    S --> TR[Translation / RAG]
    TR --> ASS[ASS Subtitle]

    ASS --> CHECK{Static ASS?}
    CHECK -- No --> LIVE[Live libass plane]
    CHECK -- Yes --> CACHE[Event Cache]

    CACHE --> PIPE[PNG image2pipe]
    LIVE --> UP[BGRA hwupload]
    PIPE --> UP

    VID[VAAPI decoded main video] --> OVER[overlay_vaapi]
    UP --> OVER

    OVER --> ENC[VAAPI Encode]
35. 关键提交时间线
| Commit | 作用 |
|---|---|
9223428 | overlay_vaapi:主视频留 GPU,只上传字幕层 |
ebd43d1 | GPU 字幕 overlay 扩展到 10-bit 视频 |
d50b781 | 减少静态字幕 overlay 尺寸和刷新工作量 |
af129c3 | 实现 ASS event-level cache |
6a913f7 | Event Cache 时间轴严格限制到真实视频 duration |
dfdd083 | 给真正的 subtitle worker 暴露 Intel GPU |
790d746 | OpenVINO 只限制 GPU 临界区,不限制整个任务池 |
8b9f06c | 增加用户可配置的在线 Whisper / Faster-Whisper API |
36. 这次优化最值得保留的工程经验
36.1 看到硬件编码器,不代表整条流水线硬件化
先画:
filter graph再找:
hwdownload
hwupload
software format conversion
很多所谓“GPU 编码慢”,其实慢在编码器前面。
36.2 先减少每次处理的数据量
这次第一阶段是:
4K full frame
↓
transparent subtitle plane
↓
bottom subtitle band
同样一个 libass,处理的数据越来越少。
36.3 再减少工作次数
然后:
60 FPS
↓
15 FPS
↓
event changes only
性能优化最后变成:
每次工作更小
×
工作次数更少
36.4 “缓存帧”不如“缓存状态”
字幕本质上经常是:
piecewise-static signal这类问题更适合:
state-oriented rendering而不是:
frame-oriented rendering这个思路还能迁移到:
- watermark;
- logo;
- lower third;
- UI overlay;
- timeline annotation;
- 静态信息条。
36.5 GPU 利用率不是最终 KPI
下面两种情况:
GPU 90%
speed 0.8x
和:
GPU 45%
speed 1.5x
第二种对业务反而更好。
最终应该看:
wall-clock time
jobs/hour
videos/hour
failure rate
cost/video
36.6 快速路径必须有 fallback
最终 VideoRoll 并没有要求:
所有 ASS 必须 Event Cache而是:
Event Cache
↓ 不支持/失败
Live GPU Overlay
↓ 不支持
Legacy Full-frame
复杂字幕可以慢,但不能错误。
36.7 并发参数必须对应具体资源
不要:
为了保护一张 GPU
把整个 Worker 设成 1
应该分别控制:
Task concurrency
GPU resource concurrency
Render concurrency
调度语义清晰以后,系统才容易继续扩展。
37. 如果重新排查一次,我会按这个顺序
Step 1:拿到真实 FFmpeg argv
ps -ef | grep '[f]fmpeg'Step 2:确认硬件能力
ffmpeg -hwaccels
ffmpeg -encoders | grep -E 'vaapi|qsv'
ffmpeg -filters | grep -E 'ass|overlay_vaapi'
Step 3:CPU 和 GPU 同时看
intel_gpu_top
top -H -p <ffmpeg-pid>
Step 4:手动画 filter graph
把每个节点标成:
hardware frame
software frame
重点圈:
hwdownload
hwupload
Step 5:问两个问题
能不能让每次工作更小?
例如:
full frame
→ subtitle plane
→ subtitle band
能不能让工作次数更少?
例如:
60 FPS
→ 15 FPS
→ event boundary only
Step 6:做视觉一致性测试
不能只验证:
FFmpeg exit code = 0至少还要验证:
frame count
duration
subtitle timing
alpha / image equivalence
38. 最终结果
我们最终从:
CPU 参与每一帧主画面的字幕烧录逐渐变成:
CPU:
只负责真正必须的软件字幕 raster

GPU:
decode
scale
overlay
encode
对于普通静态字幕,则进一步变成:
CPU / libass:
只在字幕状态变化时工作

GPU:
持续合成已经缓存好的字幕状态
也就是:
Frame-oriented subtitle rendering
            ↓
Event-oriented subtitle rendering
这是整次优化里真正产生数量级差异的地方。
39. 最后一个结论
一开始问题看起来是:
“为什么 GPU 利用率不高?”
最后真正解决的问题其实是:
“数据在整个 pipeline 里到底怎么流动?”
性能瓶颈经常不是某一个部件不够强,而是这些边界设计出了问题:
CPU
GPU
System RAM
VRAM
FFmpeg filter graph
Process/thread
Network/API
Task scheduler
这次最明显的变化并不是:
换更强显卡也不是:
把 encoder quality 调低而是把工作重新划分:
CPU 做必须的软件栅格化
GPU 做高吞吐视频处理
远程服务承担可拆分 ASR
调度层只控制对应资源
最后甚至发现:
最快的字幕帧,不是“更快地渲染出来”,而是根本不重新渲染。
Appendix A:性能数据速查
4K60 / 30s production sample

Old:
15fps live libass
30.834s
0.973x

New:
event cache
20.254s
1.481x

Wall time:
-34.3%

Throughput:
+52.2%

Cache:
210 ASS events
9 visual states
452 overlay frames
782,644 bytes
1.286s build

Visual validation:
450 / 450 alpha frames MD5 identical
0 mismatch
Appendix B:当前 Event Cache 的主要安全门
Fallback when:

- ASS has \t(...)
- ASS has \move(...)
- ASS has \fad(...)
- ASS has \fade(...)
- karaoke tags \k / \kf / \ko / \kt
- animated Effect field
- positioned / drawing ASS unsuitable for band
- too many event states
- state churn too high
- cache too large
原则:
Correctness first.
Fast path only when safe.
Appendix C:FFmpeg 快速检查清单
# Capabilities
ffmpeg -hide_banner -hwaccels
ffmpeg -hide_banner -encoders | grep -E 'vaapi|qsv'
ffmpeg -hide_banner -filters | grep -E 'ass|overlay|overlay_vaapi'

# Media
ffprobe -v error \
  -select_streams v:0 \
  -show_entries stream=width,height,r_frame_rate,pix_fmt,duration \
  -show_entries format=duration \
  -of json \
  input.mp4

# Process
ps -ef | grep '[f]fmpeg'
top -H -p <PID>

# Intel GPU
intel_gpu_top
intel_gpu_top -d drm:/dev/dri/renderD128
Appendix D:在线 Whisper 快速测试
curl \
  -X POST \
  'http://WHISPER_HOST:8000/v1/audio/transcriptions' \
  -F 'file=@audio.wav' \
  -F 'model=whisper-1' \
  -F 'response_format=verbose_json'
VideoRoll 中对应:
ASR Engine:
在线 Whisper

Service URL:
http://WHISPER_HOST:8000

Model:
whisper-1

API Key:
可选
Success
最终目标并不是“把 CPU 从系统里消灭”,而是把 CPU 从 逐帧视频主路径 中拿掉,只让它做不可避免而且低频率的字幕状态生成。
对普通静态字幕,最终从:
每帧画字幕
变成:
字幕变化时才画字幕。